Architektura zerowego zaufania
22.09.2026
Przez dziesięciolecia bezpieczeństwo systemów opisywano za pomocą metafory zamku i fosy: mocne zabezpieczenia na granicy, a za nimi obszar zaufany. Dziś ten model już nie wystarcza. Wyjaśniamy, czym jest architektura zerowego zaufania, skąd się wywodzi i jak zastosować jej zasady w systemach linuksowych. Zaczniemy od pojedynczego serwera, następnie przejdziemy do floty zarządzanej Ansiblem i usług uruchamianych w kontenerach.
Przez dziesięciolecia bezpieczeństwo systemów opisywano za pomocą metafory zamku i fosy: mocne zabezpieczenia na granicy, a za nimi obszar zaufany. Dziś ten model już nie wystarcza. Wyjaśniamy, czym jest architektura zerowego zaufania, skąd się wywodzi i jak zastosować jej zasady w systemach linuksowych. Zaczniemy od pojedynczego serwera, następnie przejdziemy do floty zarządzanej Ansiblem i usług uruchamianych w kontenerach.
Co naprawdę stanowi podstawę zaufania?
Klasyczna architektura bezpieczeństwa dzieliła infrastrukturę na dwie strefy: niezaufaną sieć zewnętrzną i zaufaną sieć wewnętrzną. Zapora chroniła granicę między nimi. Połączenia pochodzące z sieci lokalnej często przyjmowano bez dokładnej weryfikacji, ponieważ samą obecność „wewnątrz” uznawano za wystarczający dowód uprawnienia.
Ten podział przestał odpowiadać rzeczywistości. Praca zdalna, usługi chmurowe, urządzenia przenośne i tunele VPN zatarły wyraźną granicę między siecią wewnętrzną a światem zewnętrznym. Co więcej, napastnik może już znajdować się w środku: wejść dzięki wyłudzonym poświadczeniom, zainfekowanej stacji roboczej albo podatnej usłudze. W płaskiej sieci wewnętrznej może potem swobodnie przechodzić z jednej maszyny na drugą. Takie przemieszczanie się po przełamaniu pierwszego zabezpieczenia nazywamy ruchem bocznym (ang. lateral movement).
Wniosek jest prosty: położenie w sieci nie może być podstawą zaufania. Adres z sieci lokalnej nie mówi, kto wysłał pakiet ani czy nadawca ma prawo korzystać z żądanej usługi.
Od BeyondCorp do NIST SP 800-207
Pojęcie zero trust spopularyzował około 2010 roku analityk John Kindervag. W praktyce model t en rozwinęła firma Google. Po operacji „Aurora” z 2009 roku, podczas której napastnicy przeniknęli do jej sieci wewnętrznej, firma opracowała architekturę BeyondCorp. Pracownik może w niej korzystać z aplikacji firmowych z dowolnego miejsca, bez VPN-u, ale każde żądanie jest oddzielnie uwierzytelniane i autoryzowane. Decyzja zależy od tożsamości użytkownika i stanu urządzenia, a nie od adresu IP.
Formalne ramy tego modelu opisał amerykański instytut NIST w dokumencie SP 800-207 „Zero Trust Architecture” z 2020 roku. Warto go przeczytać: jest zwięzły, pozbawiony marketingowych ozdobników i precyzyjnie definiuje pojęcia używane w tym numerze. Jego najważniejsze zasady można streścić w trzech punktach:
1. Jawna weryfikacja: każde żądanie dostępu, niezależnie od miejsca pochodzenia, wymaga uwierzytelnienia i autoryzacji. Przy podejmowaniu decyzji uwzględnia się tożsamość, stan urządzenia oraz okoliczności żądania, na przykład porę, lokalizację i nietypowe zachowanie.
1. Minimalne uprawnienia: podmiot otrzymuje dostęp wyłącznie do tego zasobu, którego potrzebuje, na możliwie krótki czas. Zamiast szerokiego dostępu do sieci – dostęp do konkretnej usługi.
2. Zakładaj, że włamanie już nastąpiło: architektura ma nie tylko zapobiegać wtargnięciu, lecz także ograniczać zasięg ewentualnych szkód, nazywany promieniem rażenia. Temu służą segmentacja, szyfrowanie ruchu wewnętrznego i dokładne rejestrowanie zdarzeń.
NIST wprowadza również dwa pojęcia przydatne podczas projektowania zabezpieczeń. Punkt decyzyjny polityki (PDP, policy decision point) ocenia żądanie i rozstrzyga, czy należy je dopuścić. Punkt egzekwowania polityki (PEP, policy enforcement point) wykonuje tę decyzję. PEP-em może być zapora, serwer SSH albo moduł PAM. W rozbudowanej infrastrukturze PDP bywa osobnym systemem. Na pojedynczym serwerze obie funkcje zwykle realizują te same mechanizmy, lecz ich rozróżnienie nadal pomaga uporządkować konfigurację.
Co zerowe zaufanie oznacza dla administratora
Opisy architektury zerowego zaufania potrafią zniechęcać. Pojawiają się w nich brokerzy tożsamości, agenty instalowane na urządzeniach końcowych i mechanizmy oceny ryzyka. Można więc odnieść wrażenie, że ten model jest przeznaczony wyłącznie dla dużych organizacji. To nieprawda.
Przetłumaczmy zasady NIST na język administratora pojedynczego serwera
|
Zasada modelu |
Realizacja na serwerze linuksowym |
|
Weryfikuj jawnie |
uwierzytelnianie wieloskładnikowe w PAM, certyfikaty SSH z krótkim okresem ważności, wzajemne TLS między usługami |
|
Minimalne uprawni enia |
precyzyjne reguły sudo, konta usługowe bez powłoki, mechanizmy Protect* w systemd, pojedyncze uprawnienia (ang. capabilities) zamiast uruchamiania procesu jako root |
|
Zakładaj włamanie |
segmentacja usług (przestrzenie nazw, kontenery), zapora domyślnie blokująca również ruch wychodzący, auditd, zdalne przesyłanie dziennika |
|
Brak zaufania do sieci |
szyfrowanie także w sieci lokalnej, ograniczenie nasłuchu usług do niezbędnych interfejsów, weryfikacja tożsamości zamiast filtrowania po adresie |
|
Ciągła ocena zgodności |
regularne skany OpenSCAP, monitorowanie odchyleń od wzorcowej konfiguracji |
Zerowe zaufanie jest przede wszystkim sposobem projektowania dostępu i konfiguracji, a wiele jego zasad da się wdrożyć za pomocą narzędzi dostępnych w standardowych repozytoriach Linuksa.
Tabela wyznacza plan całego bloku. W części drugiej zajmiemy się certyfikatami SSH, w trzeciej segmentacją za pomocą przestrzeni nazw, w czwartej skanami zgodności, a w piątej zaporą nftables. W tym artykule tworzymy wspólne ramy dla tych rozwiązań. Pokażemy też, jak zastosować je do floty zarządzanej Ansiblem oraz do usług uruchamianych w kontenerach.
Krok zerowy: inwentaryzacja
Nie da się chronić zasobów, o których istnieniu nie wiemy. Zanim zmienimy pierwszy wiersz konfiguracji, musimy odpowiedzieć na trzy pytania: kto korzysta z systemu, co w nim działa i jak poszczególne elementy się komunikują.
W całym numerze będziemy pracować na tym samym przykładzie. Serwer srv-app01 działa pod kontrolą Debiana 12. Uruchomiono na nim nginx, aplikację napisaną w Pythonie i obsługiwaną przez uWSGI oraz bazę PostgreSQL.
Pierwszy aspekt to tożsamości. Wypiszmy wszystkie konta zdolne do zalogowania:
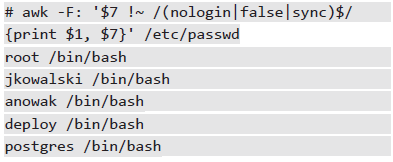
Filtr pomija konto sync, które ma powłokę /bin/synci występuje w standardowej instalacji Debiana, ale nie służy do logowania. Na liście pozostaje natomiast postgres. To konto usługowe ma pełną powłokę, choć nikt nie powinien się na nie logować, dlatego warto zmienić ją poleceniem usermod -s /usr/sbin/nologin. Konto deploy, używane przez automat wdrożeniowy, powinno otrzymać tylko niezbędne uprawnienia. Należy również sprawdzić, kto należy do grupy administracyjnej (getent group sudo) oraz jakie klucze znajdują się w plikach authorized_keys. Niepotrzebne lub nierozpoznane klucze trzeba usunąć. W następnym artykule pokażemy, jak zastąpić je certyfikatami.
Kolejny aspekt to usługi. Następnie sporządzamy listę gniazd, na których usługi oczekują na połączenia. Poniższe polecenie pokazuje wyłącznie nasłuchujące gniazda TCP (-t -l). Gniazda UDP nie mają stanu nasłuchiwania, dlatego sprawdzimy je osobno, gdy będą potrzebne:
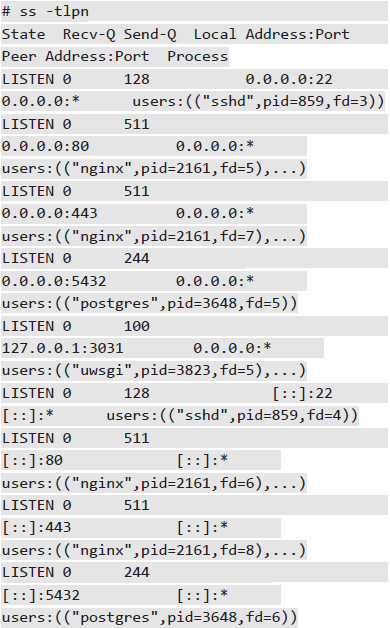
Pełny wynik jest szeroki. Do inwentaryzacji wystarczy jego skrócona postać: opcja -H pomija nagłówek, a awk wybiera adres i nazwę procesu:
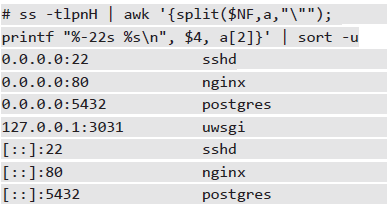
Wynik ujawnia poważny błąd: PostgreSQL nasłuchuje na wszystkich interfejsach, chociaż korzysta z niego tylko aplikacja działająca na tym samym serwerze. Nie jest to ustawienie domyślne. Debian pozostawia listen_addresses = 'localhost', więc ktoś musiał zmienić wartość na '*', zapewne po to, aby uzyskać zdalny dostęp do bazy. Sama zapora na granicy sieci nie uzasadnia tak szerokiego nasłuchu. Usługa powinna być dostępna wyłącznie dla klientów, którzy jej potrzebują, ponieważ każdy dodatkowy adres nasłuchu zwiększa ryzyko ataku.
Drugi wniosek łatwo przeoczyć: każda z tych usług nasłuchuje również przez IPv6, co pokazują wiersze z adresem [::]. Jeżeli sprawdzimy tylko wpisy z 0.0.0.0, pominiemy część dostępnych gniazd. Podobnie reguły zapory utworzone wyłącznie w rodzinie ip, a nie inet, nie obejmą ruchu IPv6. Wrócimy do tego w części piątej.
Wreszcie pora na przepływy. Rysujemy macierz komunikacji: kto z kim rozmawia, po jakim porcie i w jakim celu. Dla srv-app01 wygląda ona tak:
|
Źród ło |
Cel |
Port |
Cel biznesow y |
|
Internet |
nginx |
443 |
ruch użytkowników |
|
nginx |
uWSGI |
3031 |
przekazanie żądań do aplikacji |
|
aplikacja |
PostgreSQL |
5432 |
zapytania do bazy |
|
stacje administratorów |
sshd |
22 |
administracja |
|
serwer |
repozytoria APT |
443 |
aktualizacje |
|
serwer |
kolektor dziennika |
6514 |
zdalna kopia zdarzeń |
Każdy przepływ, którego nie ma w tej tabeli, powinien być zabroniony w obu kierunkach. W ostatnim artykule w tym numerze na podstawie macierzy utworzymy reguły nftables. Na razie opisuje ona jedynie wymagane połączenia.
Filar pierwszy : tożsamość silniejsza niż hasło
Skoro nie ufamy położeniu w sieci, musimy wiarygodnie potwierdzać tożsamość użytkownika. Nawet długie hasło jest poświadczeniem statycznym, które można wyłudzić. Pierwszym praktycznym krokiem będzie więc wprowadzenie uwierzytelniania wieloskładnikowego przy logowaniu przez SSH.
W Debianie i systemach pochodnych można użyć pakietu libpam-google-authenticator. Mimo nazwy moduł nie wymaga usług Google’a, lecz realizuje otwarty standard TOTP zdefiniowany w dokumencie RFC 6238. Każdy użytkownik generuje własny sekret poleceniem google-authenticator. Następnie konfigurujemy PAM i sshd. W obu konfiguracjach znajdują się istotne szczegóły, które łatwo przeoczyć.
PAM. W domyślnym pliku usługi sshd Debian dołącza do stosu auth konfigurację common-auth, która sprawdza hasło uniksowe. Samo dopisanie modułu TOTP na końcu pliku nie wyłącza tego sprawdzenia. Serwer nadal wymagałby hasła, a następnie kodu jednorazowego. Dlatego wiersz dołączający common-auth trzeba zakomentować:
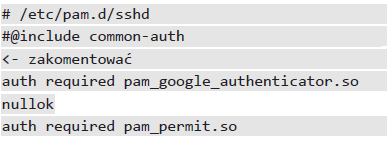
Moduł pam_permit.so jest potrzebny podczas migracji. Jeżeli użytkownik nie ma jeszcze pliku ~/.google_authenticator, moduł TOTP z opcją nullok pomija sprawdzenie i nie zwraca powodzenia. Stos auth, w którym żaden moduł nie potwierdził użytkownika, odrzuca logowanie. Bez pam_permit.so osoby, które nie skonfigurowały jeszcze TOTP, nie mogłyby się zalogować. Po zakończeniu migracji usuwamy zarówno opcję nullok, jak i wiersz z pam_permit.so.
sshd. W konfiguracji sshd obowiązuje pierwsze wystąpienie danej dyrektywy, a nie ostatnie. Debian zawiera już ustawienie KbdInteractiveAuthentication no, dlatego przeciwna wartość dopisana na końcu sshd_config zostałaby zignorowana. Polecenie sshd -t zgłosiłoby wtedy błąd AuthenticationMethods cannot be satisfied by enabled authentication methods. Główny plik wcześniej dołącza jednak /etc/ssh/sshd_config.d/*.conf. Właśnie tam należy umieścić własną konfigurację, aby została odczytana przed ustawieniami domyślnymi:
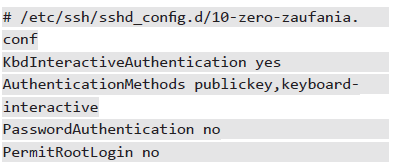
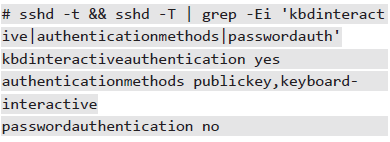
Dyrektywa AuthenticationMethods publickey,keyboard-interactive wymaga kolejno obu składników: najpierw klucza, a docelowo certyfikatu, następnie kodu jednorazowego. Ustawienie PasswordAuthentication no wyłącza tylko metodę SSH o nazwie password. Nie wyłącza sprawdzania hasła przez PAM w ramach metody keyboard-interactive. Jeśli pozostawimy @include common-auth, po przyjęciu klucza serwer nadal zapyta o hasło. Skuteczną konfigurację sprawdzamy poleceniem, a nie na podstawie samej treści pliku:
Przed zamknięciem sesji, w której zmienialiśmy konfigurację sshd, należy otworzyć drugie połączenie i sprawdzić logowanie. Ustawienie PermitRootLogin no zaczyna obowiązywać natychmiast po przeładowaniu usługi, dlatego błąd może pozbawić administratora dostępu do serwera. Jeżeli maszyna nie ma konsoli awaryjnej, warto wcześniej uruchomić czasowe zadanie, które po pięciu minutach przywróci poprzedni plik. Po udanym teście zadanie trzeba anulować:
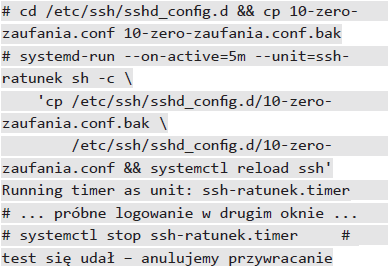
W poleceniu podajemy pełne ścieżki i jawnie wywołujemy sh -c. W Debianie /bin/sh wskazuje na powłokę dash, która, w przeciwieństwie do basha, nie rozwija nawiasów klamrowych. Samo systemd-run nie uruchamia powłoki: bez sh -c wykonałoby wskazany program bezpośrednio.
Drugim elementem tego filaru są poświadczenia krótkotrwałe. Klucz SSH skopiowany wiele lat temu na liczne maszyny nie wygasa, trudno ustalić wszystkie miejsca jego przechowywania, a unieważnienie wymaga zmiany konfiguracji każdego serwera. Certyfikaty SSH rozwiązują ten problem dzięki okresowi ważności liczonemu w godzinach. Szczegółowo omawiamy je w następnym artykule.
Filar drugi: minimalne uprawnienia
Na serwerze linuksowym zasada minimalnych uprawnień dotyczy zarówno użytkowników, jak i usług.
Użytkownicy. Wpis jkowalski ALL=(ALL:ALL) ALL w pliku sudoers przyznaje pełne uprawnienia adm inistracyjne. Przejęcie takiego konta oznacza przejęcie całego serwera. Zamiast przyznawać nieograniczony dostęp, definiujemy role. Jeżeli użytkownik jkowalski odpowiada za aplikację, można nadać mu następujące uprawnienia:
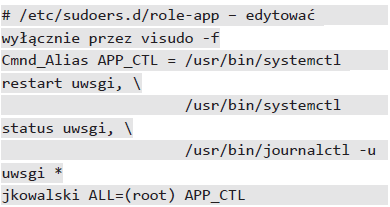
Konto deploy nie powinno mieć ogólnego dostępu do sudo. Jeżeli automat wdrożeniowy musi przeładować usługę, należy zezwolić mu tylko na tę konkretną operację, na przykład przez regułę sudo ograniczoną do jednego polecenia albo za pomocą mechanizmu polkit. W pliku sudoers warto również ustawić Defaults log_input, log_output. Zapis sesji administracyjnych ułatwia późniejszą analizę incydentu.
Usługi. Systemd udostępnia wiele mechanizmów ograniczających uprawnienia procesów. Zanim jednak użyjemy systemctl edit, sprawdźmy rodzaj jednostki:
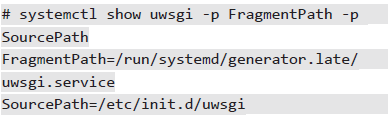
Pakiet uwsgi w Debianie 12 nie zawiera natywnej jednostki systemd. Usługę uruchamia skrypt SysV, dla którego systemd-sysv-generator tworzy tymczasową jednostkę w katalogu /run. Dyrektywy utwardzające dodane do takiej jednostki nie muszą obejmować procesów uruchamianych przez skrypt, a mogą uniemożliwić start samej usługi. Na przykład ProtectSystem=strict odbiera skryptowi prawo zapisu do /run/uwsgi. Dlatego najpierw zastępujemy wygenerowaną jednostkę jednostką natywną:
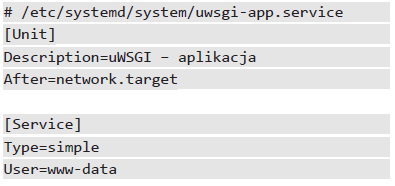
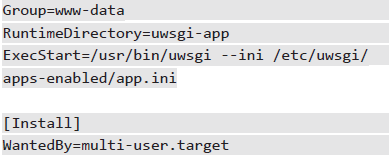
Dopiero teraz systemctl edit uwsgi-app.service ma sens:
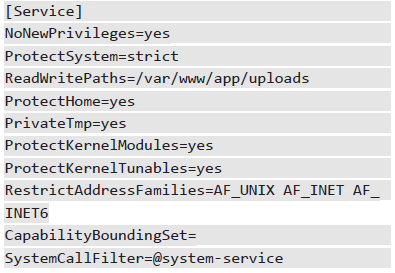
Te dyrektywy ograniczają skutki ewentualnego zdalnego wykonania kodu w aplikacji. Proces nie może uzyskać nowych uprawnień (NoNewPrivileges), modyfikować modułów jądra ani parametrów sysctl, a także korzystać z niedozwolonych wywołań systemowych. Trzeba przy tym dokładnie rozumieć działanie ProtectSystem=strict. Katalogi /etc, /usr, /var oraz /run stają się niezapisywalne, lecz zapis nadal jest możliwy w prywatnym /tmp utworzonym przez PrivateTmp=yes, w katalogu zadeklarowanym przez RuntimeDirectory= oraz w ścieżkach wymienionych w ReadWritePaths=. Dlatego natywna jednostka deklaruje RuntimeDirectory=uwsgi-app. Bez tego uWSGI nie mógłby utworzyć gniazda ani pliku PID.
Poziom zabezpieczeń oceniamy poleceniem:
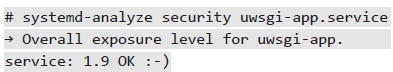
W teście na Debianie 12 z systemd 252.39 otrzymaliśmy wynik 1,9. Jest to wartość heurystyczna, zależna od wersji systemd i konfiguracji jednostki, dlatego nie należy porównywać jej bezpośrednio między dystrybucjami. Ważniejsze są klasa OK i lista brakujących zabezpieczeń. Nieutwardzona jednostka usługi sieciowej zwykle otrzymuje ocenę UNSAFE. Szczegółowy wynik polecenia wskazuje brakujące mechanizmy i pomaga stopniowo utwardzać kolejne usługi.
Filar trzeci: zakładaj włamanie
Trzecia zasada wymaga od nas pokory: projektujemy system tak, jakby przełamanie pierwszej warstwy było kwestią czasu. Z tego założenia wynikają trzy praktyczne obowiązki.
Segmentacja. Usługi na srv-app01 rozdzielimy w taki sposób, aby przejęcie jednej z nich nie zapewniało dostępu do pozostałych. Bazę danych umieścimy w osobnej sieciowej przestrzeni nazw i udostępnimy ją tylko przez jeden kontrolowany punkt połączenia. Całą procedurę opisujemy w trzecim artykule w tym magazynie. Po jej wdrożeniu proces nginx nie będzie miał dostępu do portu 5432, nawet jeżeli zostanie przejęty.
Rejestracja zdarzeń poza serwerem. Po włamaniu napastnik może usunąć lub zmienić lokalny dziennik, aby zatrzeć ślady. Dlatego zdarzenia trzeba przesyłać także poza chroniony serwer. Najpierw konfigurujemy auditd tak, aby rejestrował co najmniej zmiany w najważniejszych plikach oraz użycie uprawnień administracyjnych:
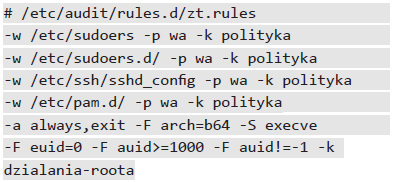
Ostatnia reguła rejestruje każde polecenie wykonane z uprawnieniami roota przez zalogowanego użytkownika. Pole auid zachowuje tożsamość użytkownika sprzed podniesienia uprawnień, dzięki czemu audyt dostarcza wiarygodniejszych informacji niż historia powłoki. Warunek auid!=-1 pomija procesy systemowe, którym jądro nie przypisało tożsamości użytkownika. Nowsze wersje auditctl przyjmują również czytelniejszy zapis auid!=unset; w wyniku auditctl -l obie postacie są przedstawiane jako -1.
Pełny plik dołączony do materiałów rejestruje również użycie konta ratunkowego. Przed załadowaniem reguły -w /home/ratunek/.ssh/authorized_keys trzeba utworzyć konto, katalog .ssh i sam plik, ponieważ auditctl nie przyjmuje reguły dla nieistniejącej ścieżki. Regułę -e 2, która blokuje dalsze zmiany konfiguracji audytu aż do ponownego uruchomienia systemu, umieszczamy na końcu. Włączamy ją dopiero po sprawdzeniu całego zestawu.
Zdarzenia przesyłamy na bieżąco do zdalnego kolektora. Dostępne rozwiązania korzystają z różnych portów. systemd-journal-upload łączy się z systemd-journal-remote przez HTTPS na porcie 19532. Rsyslog z transportem TLS używa natomiast portu 6514 zgodnie z RFC 5425; w /etc/services port ten figuruje jako syslog-tls. W naszej macierzy przepływów podaliśmy port 6514. Po wybraniu rozwiązania opartego na systemd trzeba zastąpić go portem 19532.
Kontrola ruchu wychodzącego. Klasyczne konfiguracje często ograniczają tylko ruch przychodzący. Taka zapora nie powstrzyma napastnika przed połączeniem z serwerem dowodzenia ani przed wysłaniem skradzionych danych. Serwer powinien inicjować wyłącznie połączenia wymienione w macierzy przepływów, na przykład z repozytoriami pakietów, kolektorem dziennika oraz serwerami NTP i DNS. Reguły nftables realizujące tę politykę przedstawimy w ostatnim artykule w tym magazynie.
Filar czwarty: weryfikacja ciągła
Zasada zerowego zaufania obejmuje także stan konfiguracji. Ustawienia zgodne z przyjętym wzorcem mogą z czasem ulec zmianie wskutek aktualizacji, napraw awaryjnych i tymczasowych wyjątków. Takie stopniowe odchodzenie od wzorca, nazywane dryfem konfiguracji, należy uznać za normalne zjawisko i systematycznie je wykrywać.
Potrzebna jest zatem regularna, zautomatyzowana kontrola zgodności ze wzorcem. W czwartym artykule w niniejszym magazynie wykorzystamy do tego OpenSCAP z profilami CIS. Cotygodniowy skan, uruchamiany przez czasomierz systemd, porówna stan serwera ze wzorcem i zgłosi każde odchylenie. Zgodność konfiguracji potwierdzamy więc cyklicznie, podobnie jak tożsamość logujących się użytkowników.
Skala: od jednego serwera do floty
Dotychczas zajmowaliśmy się jednym serwerem, srv-app01. W praktyce administrator zwykle odpowiada za kilkanaście lub kilkaset maszyn i zarządza ich konfiguracją za pomocą narzędzia takiego jak Ansible. Zasady zerowego zaufania pozostają te same, ale zmieniają się miejsce egzekwowania polityki oraz najważniejszy chroniony zasób.
Ręczna edycja plików nie sprawdza się w dużej skali i utrudnia kontrolę zgodności. Po kilku miesiącach nie można mieć pewności, że sshd_config wygląda tak samo na wszystkich hostach. Dla floty plik konfiguracji staje si ę deklaracją polityki, a węzeł sterujący rozprowadza ją do punktów egzekwowania na poszczególnych serwerach. Ten sam dodatkowy plik konfiguracyjny sshd wdrażamy na całą grupę hostów i sprawdzamy przed zastosowaniem:
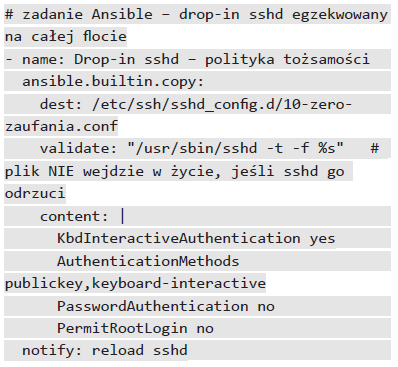
Odpowiednikiem trybu obserwacyjnego jest polecenie ansible-playbook --check --diff. Pokazuje ono, co zostałoby zmienione na każdym hoście, ale nie wprowadza zmian. Idempotencja pomaga również wykrywać odchylenia konfiguracji. Drugi przebieg na zgodnej flocie powinien zakończyć się wynikiem changed=0. Każdy host oznaczony jako zmieniony wymaga sprawdzenia.
Ważny wyjątek dla automatyzacji. Wymuszenie AuthenticationMethods publickey,keyboard-interactive na całej flocie może zablokować połączenia Ansible. Narzędzie łączy się przez SSH za pomocą klucza i nie może podać interaktywnego drugiego składnika. Po zastosowaniu takiej polityki otrzyma więc błąd Permission denied (keyboard-interactive), a węzeł sterujący utraci dostęp do zarządzanych maszyn. Dodatkową trudność powoduje PermitRootLogin prohibit-password, ponieważ dyrektywa zabrania użytkownikowi root wszystkich metod interaktywnych. W połączeniu z obowiązkowym drugim składnikiem całkowicie uniemożliwia logowanie na to konto.
Rozwiązaniem jest osobne konto automatyzacji, które nie działa jako root i otrzymuje ściśle określony wyjątek od interaktywnego drugiego składnika. W poniższym przykładzie konto automat może uwierzytelnić się samym kluczem, ale tylko wtedy, gdy połączenie pochodzi z adresu węzła sterującego:
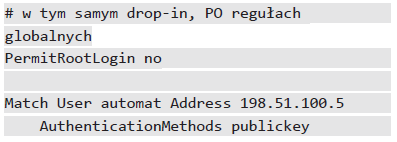
Ograniczenie adresu źródłowego nie jest drugim składnikiem uwierzytelnienia, ale zmniejsza ryzyko wynikające z jego braku na koncie automatyzacji. W kolejnym artykule pokażemy, jak umieścić to ograniczenie bezpośrednio w certyfikacie SSH za pomocą opcji source-address. Użytkownicy będą logować się kluczem i kodem TOTP, automat użyje klucza powiązanego ze źródłem połączenia, a zdalne logowanie na konto root pozostanie wyłączone. Po wdrożeniu sprawdzamy skuteczne ustawienia na całej flocie, a nie tylko treść pliku:
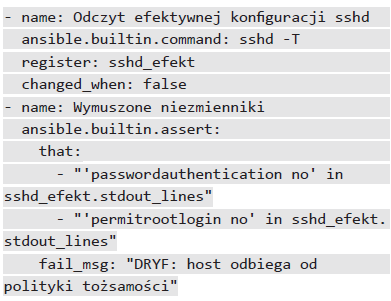
Trzeba przy tym pamiętać o pierwszeństwie dyrektyw sshd. Obowiązuje pierwsze wystąpienie ustawienia, więc późniejszy plik 99-wyjatek.conf z dyrektywą PasswordAuthentication yes nie zmieni wartości ustalonej wcześniej w 10-zero-zaufania.conf. Nadal należy jednak sprawdzać skuteczną konfigurację poleceniem sshd -T. Samo istnienie pliku nie wykryje jego usunięcia, edycji ani innego odchylenia wpływającego na wynik.
Najważniejszym chronionym zasobem staje się teraz węzeł sterujący. Jego poświadczenia zapewniają dostęp do wszystkich serwerów floty, więc przejęcie węzła może oznaczać przejęcie całego środowiska. Należy zatem ograniczyć działające na nim usługi, wymagać od administratorów uwierzytelniania wieloskładnikowego i wysyłać dziennik na zewnętrzny serwer. Sekrety, takie jak hasła do magazynu Ansible Vault i klucze, powinny być zaszyfrowane podczas przechowywania, a dostęp do nich ściśle kontrolowany. Zarządzanie konfiguracją, sekretami i odtwarzalnością floty omówimy szczegółowo w numerze poświęconym automatyzacji. Przejście od jednego serwera do floty przenosi znaczną część kontroli na płaszczyznę sterowania, lecz nie zmienia zasad zerowego zaufania.
Zerowe zaufanie a kontenery
Częstym błędem jest uznawanie kontenera za wystarczającą granicę bezpieczeństwa. Sama konteneryzacja nie zapewnia pełnej izolacji. Kontener korzysta z mechanizmów jądra, takich jak przestrzenie nazw, grupy kontrolne i uprawnienia (ang. capabilities). Te same mechanizmy zastosujemy bezpośrednio za pomocą ip netnsw artykule o segmentacji sieci. Kontenery ułatwiają segmentację, lecz ich ustawienia domyślne nie zawsze odpowiadają zasadom zerowego zaufania. Zastosujmy więc cztery filary do kontenerów na przykładzie Podmana 4.3.1 z Debiana 12.
Weryfikuj jawnie – pochodzenie obrazu. Obraz pobrany z sieci zawiera kod, który otrzyma uprawnienia uruchamianej usługi. Domyślna polityka Podmana przyjmuje każdy obraz bez sprawdzania jego pochodzenia:
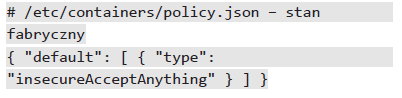
Zmieniamy zasadę domyślną: odrzucamy obrazy spoza zaufanego źródła, a docelowo wymagamy również ich podpisania:
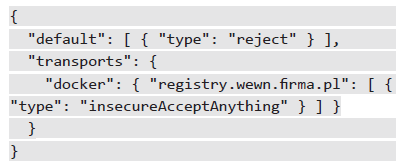
Przy takiej polityce próba pobrania obrazu spoza firmowego rejestru kończy się komunikatem Source image rejected. Podobnie jak w przypadku użytkowników, samo pochodzenie żądania nie jest podstawą domyślnego zaufania.
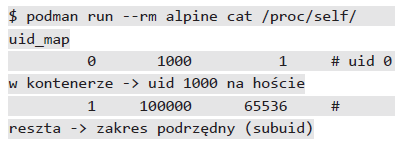
Minimalne uprawnienia – tryb bez uprawnień roota i ograniczanie uprawnień procesu. Tradycyjna architektura Dockera korzysta z demona działającego jako root, którego przejęcie może prowadzić do przejęcia hosta. Podman może natomiast działać w trybie bez uprawnień roota (rootless). Dzięki przestrzeni nazw użytkowników proces o identyfikatorze uid=0 w kontenerze odpowiada zwykłemu, nieuprzywilejowanemu kontu na hoście. Ogranicza to skutki przejęcia kontenera, ale nie chroni przed każdą podatnością jądra. Mapowanie identyfikatorów można sprawdzić bezpośrednio:
Dodatkowo odbieramy procesowi wszystkie zbędne uprawnienia i montujemy system plików kontenera tylko do odczytu, podobnie jak podczas utwardzania jednostek systemd:
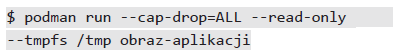
W teście proces uruchomiony bez --cap-drop otrzymał ograniczony, ale niepusty zestaw uprawnień (CapEff: 00000000800405fb). Po dodaniu --cap-drop=ALL wartość wyniosła zero (0000000000000000). Próba użycia portu poniżej 1024 nie jest jednak uniwersalnym sposobem sprawdzenia tej zmiany, ponieważ zależy także od parametru net.ipv4.ip_unprivileged_port_start. Przy opcji --read-only zapis w głównym systemie plików kończy się błędem Read-only file system. Zapisywalny pozostaje tylko jawnie wskazany --tmpfs /tmp. Jest to kontenerowy odpowiednik połączenia ProtectSystem=strictz ReadWritePaths=.
Zakładaj włamanie – sprawdzaj granice izolacji. W standardowym trybie bez uprawnień roota adres 127.0.0.1 wewnątrz kontenera wskazuje jego własny interfejs zwrotny, a nie hosta. W naszym teście kontener nie mógł więc połączyć się z usługą nasłuchującą na 127.0.0.1 hosta. Wyjątkiem jest jawnie wybrany tryb --network=host, w którym kontener współdzieli stos sieciowy gospodIzolacji nie zapewnia natomiast samo utworzenie oddzielnych sieci mostkowych. Dwie sieci Podmana utworzone z uprawnieniami roota nie muszą być od siebie odizolowane. W teście na Debianie 12 z Podmanem 4.3.1 kontener w sieci netB mógł wysyłać pakiety do kontenera w netA. Opcja --internal blokuje ruch poza daną sieć, ale nie gwarantuje izolacji między wszystkimi mostami. W nowszym mechanizmie Netavark służy do tego opcja sieci -o isolate=1; w starszych wersjach trzeba sprawdzić dostępne rozwiązanie i jego działanie. Niezależnie od używanego mechanizmu izolację potwierdzamy testem ruchu. Jeżeli polityka ma być przewidywalna, egzekwujemy ją również za pomocą zapory hosta.
Weryfikacja ciągła – kontener jako jednostka systemd. Kontenera produkcyjnego nie należy uruchamiać ręcznie. Podman może wygenerować dla niego jednostkę systemd poleceniem podman generate systemd; w wersji 4.4 i nowszych można użyć plików Quadlet. Dzięki temu system uruchamia kontener podczas rozruchu, nadzoruje go i w razie potrzeby ponownie uruchamia. Można też stosować dyrektywy utwardzające oraz ocenę systemd-analyze security, podobnie jak dla usług natywnych. W kontenerach również trzeba zatem sprawdzać pochodzenie obrazu, uprawnienia procesu, granice izolacji i zgodność konfiguracji.
Plan wdrożenia
Zakres zmian może początkowo wydawać się zbyt duży. Poniższa kolejnoś ć pozwala wdrażać zabezpieczenia etapami, zaczynając od działań przynoszących największy efekt przy niewielkim nakładzie pracy:
1. Tydzień 1 – inwentaryzacja. Spisujemy konta, klucze, usługi i wymagane przepływy. Nie zmieniamy jeszcze konfiguracji. Już samo rozpoznanie stanu zwykle ujawnia porzucone konta i usługi dostępne przez zbyt wiele interfejsów.
2. Tydzień 2 – tożsamość. Wyłączamy logowanie przez SSH za pomocą hasła oraz bezpośrednie logowanie na konto root. Wdrażamy TOTP, przeglądamy klucze i wymieniamy te, których nie można uznać za bezpieczne. Następnie przechodzimy na certyfikaty opisane w kolejnym artykule.
3. Tydzień 3 – minimalne uprawnienia. Tworzymy reguły sudo odpowiadające rolom użytkowników, utwardzamy jednostki systemd i analizujemy wyniki systemd-analyze security.
4. Tydzień 4 – segmentacja i zapora. Rozdzielamy usługi za pomocą przestrzeni nazw opisanych w trzecim artykule. Wprowadzamy politykę domyślnej odmowy ruchu w obu kierunkach zgodnie z instrukcjami, które znajdują się w ostatnim artykule. Najpierw tylko rejestrujemy ruch, a po tygodniu obserwacji zaczynamy go blokować.
5. Stale – audyt i zgodność. Przesyłamy dziennik na zewnętrzny serwer, utrzymujemy reguły auditd i cyklicznie wykonujemy skany OpenSCAP opisany w czwartym artykule.
Plan dotyczy pojedynczego serwera, lecz każdy krok można i należy zapisać jako kod stosowany do całej floty. Jeżeli zarządzamy więcej niż jedną maszyną, warto od początku wprowadzać zmiany za pomocą playbooka Ansible. Inwentaryzacja obejmie wtedy spis hostów, a ustawienia tożsamości i minimalnych uprawnień staną się rolami stosowanymi jednakowo na wszystkich serwerach. Opcje --check --diff oraz idempotencja ułatwią stałe wykrywanie odchyleń. Przed wymuszeniem interaktywnego drugiego składnika trzeba wdrożyć opisany wcześniej wyjątek dla konta automatyzacji. W przeciwnym razie węzeł sterujący utraci dostęp do zarządzanych maszyn. Sam węzeł wymaga co najmniej tak samo rygorystycznej ochrony jak pozostałe serwery.
Na koniec trzeba uwzględnić dwa środki ostrożności. Po pierwsze, zmianę ograniczającą dostęp należy początkowo uruchomić w trybie obserwacyjnym. Macierz przepływów może pomijać rzadkie, ale prawidłowe połączenia, na przykład wykonywanie kopii zapasowej, przesyłanie miesięcznego raportu lub działanie starszego systemu monitorowania. Po drugie, trzeba przygotować awaryjną drogę dostępu: konsolę szeregową, konsolę KVM udostępnianą przez dostawcę albo osobne konto ratunkowe z poświadczeniem przechowywanym w bezpiecznym miejscu. Zabezpieczenia nie powinny uniemożliwiać usunięcia awarii.
Słowniczek pojęć
|
Zerowe zaufanie (zero trust) – model bezpieczeństwa, w którym żaden podmiot ani żadna lokalizacja sieciowa nie są obdarzone domyślnym zaufaniem; każde żądanie dostępu podlega osobnej weryfikacji. |
|
Punkt decyzyjny polityki (PDP) – komponent oceniający żądanie dostępu i wydający decyzję na podstawie zdefiniowanej polityki. |
|
Punkt egzekwowania polityki (PEP) – komponent wcielający decyzję w życie: zapora, serwer SSH, moduł PAM, serwer pośredniczący. |
|
Ruch boczny (lateral movement) – przemieszczanie się napastnika między systemami wewnątrz sieci po przełamaniu pierwszego zabezpieczenia. |
|
Mikrosegmentacja – podział infrastruktury na małe, wzajemnie odizolowane strefy z kontrolowanymi punktami połączenia; na pojedynczym serwerze realizowana między innymi za pomocą przestrzeni nazw. |
|
Zasada minimalnych uprawnień (least privilege) – przydzielanie podmiotom wyłącznie tych uprawnień, które są niezbędne do wykonania zadania, na możliwie krótki czas. |
|
Promień rażenia (blast radius) – zasięg szkód, jakie może wyrządzić kompromitacja pojedynczego komponentu; celem architektury jest jego minimalizacja. |
|
Poświadczenie krótkotrwałe – klucz, certyfikat lub token z krótkim okresem ważności, którego wygaśnięcie nie wymaga ręcznego unieważniania. |
|
Płaszczyzna sterowania (control plane) – węzeł i narzędzia zarządzające konfiguracją floty, na przykład Ansible; jest szczególnie ważnym celem ochrony, ponieważ jej przejęcie może oznaczać przejęcie wszystkich zarządzanych maszyn. |
|
Konto automatyzacji – nieosobowe konto, za którego pomocą płaszczyzna sterowania łączy się z serwerami; nie działa jako root, a brak interaktywnego drugiego składnika jest kompensowany ograniczeniem źródła połączenia, na przykład opcją source-address w certyfikacie. |
|
Tryb bez uprawnień roota (rootless) – uruchamianie kontenerów bez uprawnień administratora; dzięki przestrzeni nazw użytkowników „root” wewnątrz kontenera odpowiada nieuprzywilejowanemu kontu na hoście. |
|
Pochodzenie obrazu (provenance) – udokumentowane, weryfikowalne źródło obrazu kontenera (zaufany rejestr, podpis); podstawa zasady „weryfikuj jawnie” w warstwie kontenerów. |
Więcej podobnych
Aktualnie przeglądasz